功能概览
InspireFace 将基础检测、跟踪和可选分析模型分开。可以先创建一个检测人脸的会话,再根据实际需要启用识别、质量或其他分析功能。
这一页说明各项功能返回什么数据。功能指南提供 C API、C++、Android、HarmonyOS、Python、Objective-C 和 Swift 示例,可按支持的接口切换查看。可以通过 API 功能索引查找具体流程,也可以在完整示例中直接复制代码。
人脸跟踪
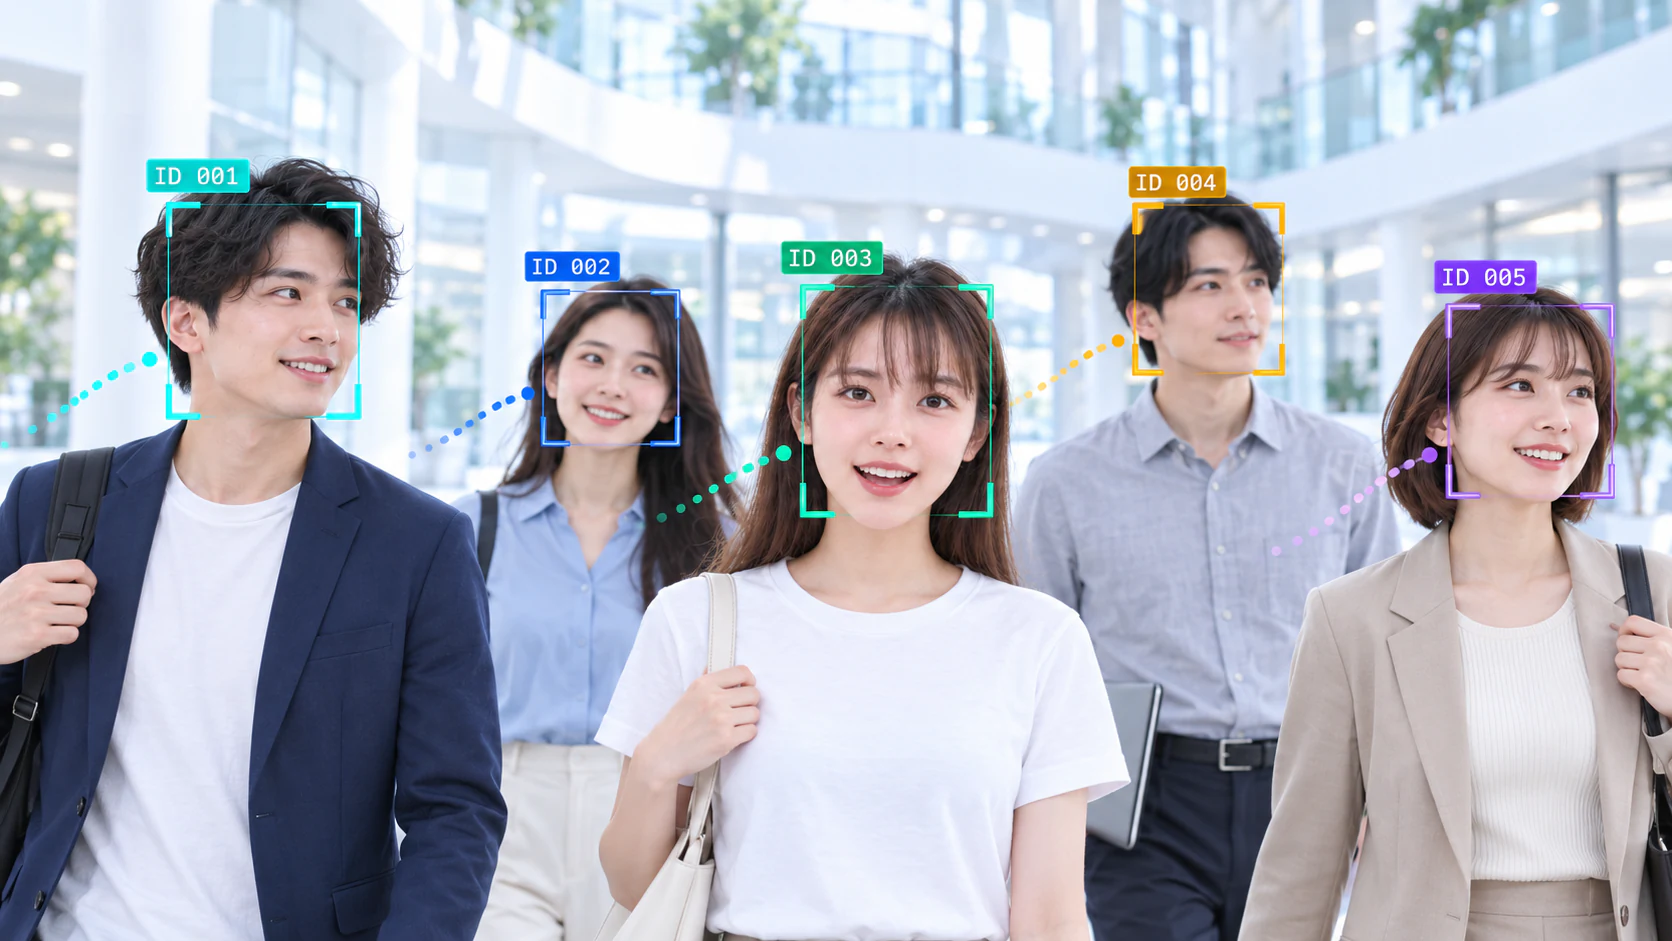
互不相关的照片使用检测模式;同一相机的连续帧使用跟踪模式。跟踪会话会保存历史,需要按顺序提交帧并持续复用会话。切换相机或输入发生较大跳变时,应重新开始跟踪。
每张人脸的结果包含检测框、检测置信度、跟踪 ID 和跟踪次数。track ID 用于在同一段视频中关联人脸标记和应用状态。需要跨会话确认人员身份时,使用人脸识别。
| Mode | 常见输入 | 处理方式 |
|---|---|---|
| Always detect | 照片或互不相关的帧 | 每次调用都执行检测。 |
| Light track | 连续相机视频 | 在检测间隔内利用历史信息跟踪。 |
| Track by detection | 基于检测结果关联的视频序列 | 每帧执行检测,再关联检测结果形成轨迹。 |
检测输入档位决定每次检测的计算量,与相机分辨率不是同一个参数。跟踪指南介绍了检测档位、最小人脸尺寸和平滑设置。
人脸特征向量
特征向量是从检测到的人脸中提取的数值表示,用于人脸比对和特征库检索。处理流程先检测人脸并完成对齐,再提取用于比对的向量。
创建会话时启用 HF_ENABLE_FACE_RECOGNITION,再使用同一张图像及其人脸结果提取特征。提取完成前,保留原图像素。
# session has HF_ENABLE_FACE_RECOGNITION enabled; image is a BGR array.
faces = session.face_detection(image)
if len(faces) == 1:
    embedding = session.face_feature_extract(image, faces[0])
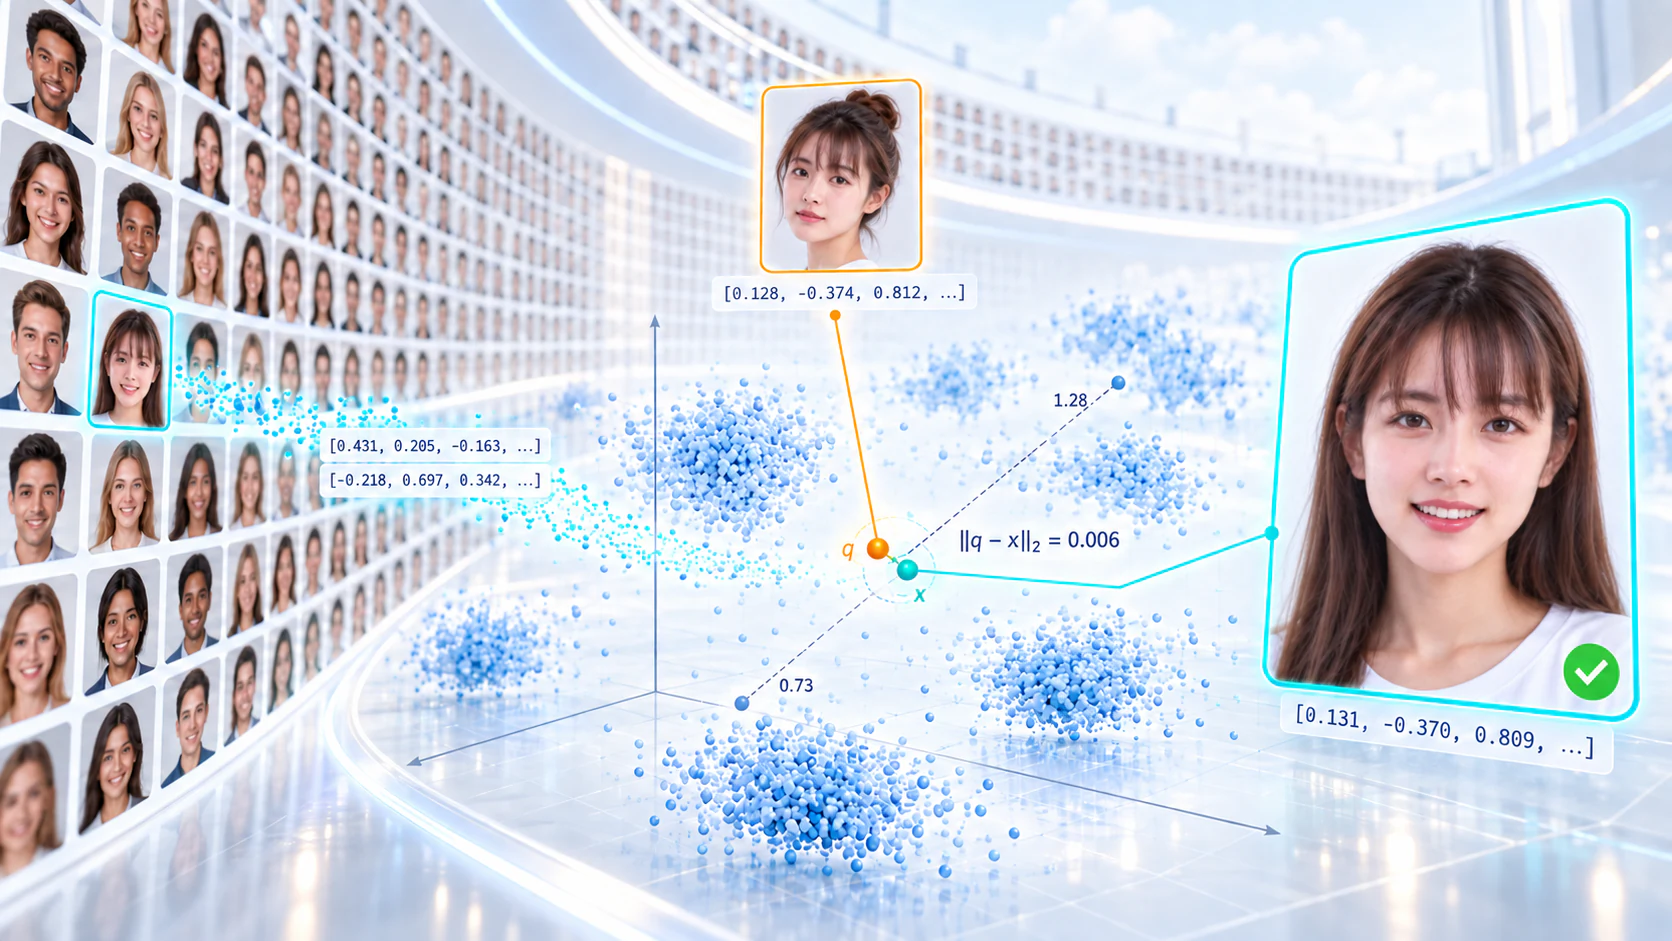
同一个特征库使用同一识别模型提取的向量。更换模型时,使用新模型重新提取录入图像,更新库中的特征。
人脸属性分析
可选模型为每张人脸返回口罩分数、属性类别和表情类别。读取分数或类别索引后,再映射为界面中使用的标签。输入图像应尽量清晰,并保持正确朝向。
| Output | Session option | 说明 |
|---|---|---|
| Mask | HF_ENABLE_MASK_DETECT | 返回佩戴口罩的置信度。 |
| Attributes | HF_ENABLE_FACE_ATTRIBUTE | 返回年龄段和属性类别索引。 |
| Expression | HF_ENABLE_FACE_EMOTION | 返回表情类别索引。 |
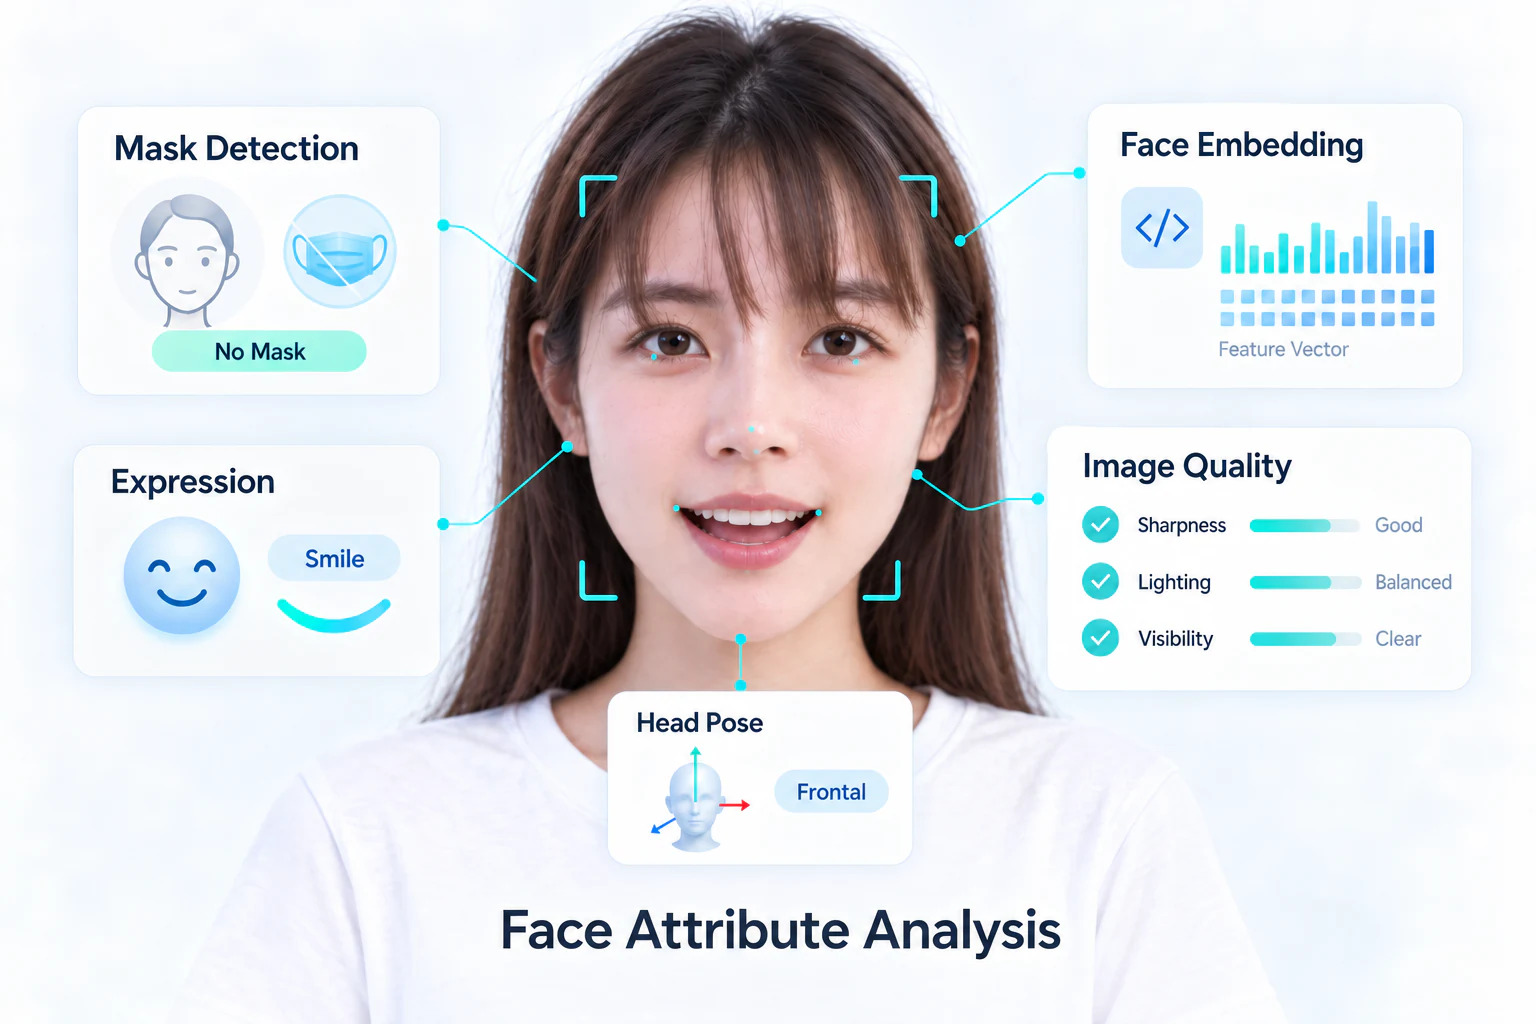
检测完成后再调用人脸分析流水线,请求的功能也必须在创建会话时启用。人脸分析指南提供各 API 的结果读取示例,并说明对应的 Android 包配置。类别标签顺序见 Python 说明。
人脸识别
一对一比对需要比较两个特征向量;一对多识别需要检索特征库。两者都会返回相似度,应用应根据输入条件选择阈值,并决定如何处理不确定的匹配。
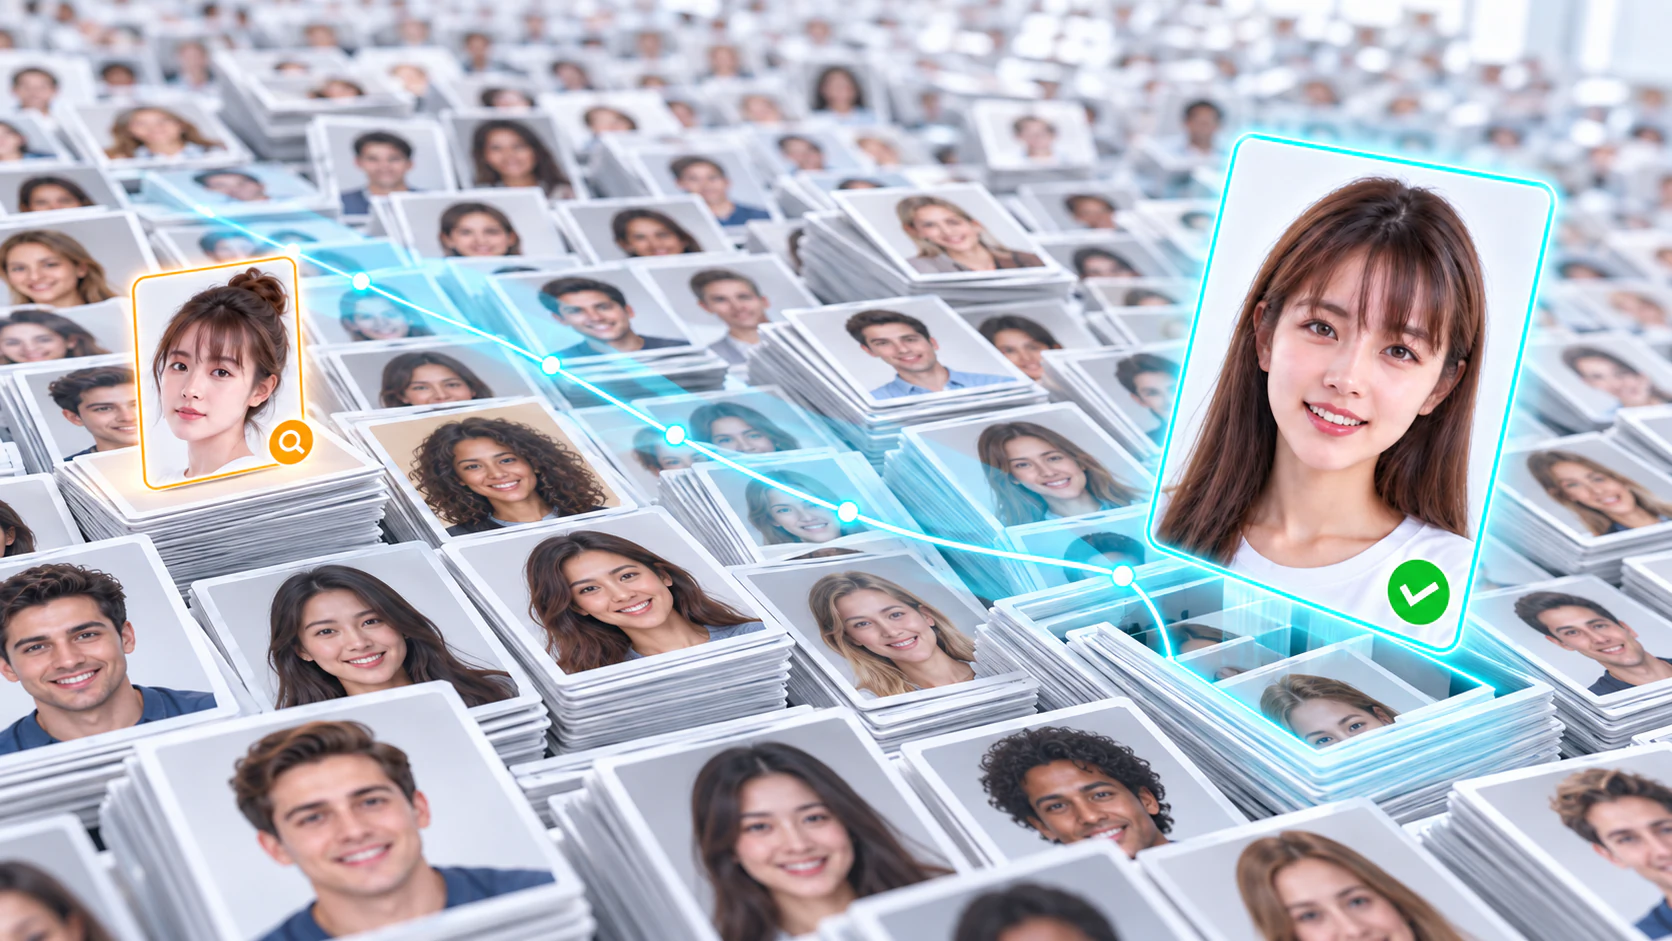
先使用模型推荐的余弦相似度阈值,再用实际摄像头拍摄的同人、非同人图像对验证。判断时比较原始余弦分数和阈值,百分比转换用于界面显示。
录入时先选择目标人脸,再检查图像质量。多人合照可以让用户点选人脸后再提取特征。完整比对示例和特征库生命周期见识别与特征库。
人脸质量评估
质量评估用于判断一张人脸图像是否适合后续处理,例如选择录入图片,或等待质量更好的相机帧。启用 HF_ENABLE_QUALITY,执行分析流水线后,即可读取每张人脸的质量分数。
分析示例展示了质量、口罩、属性和姿态结果的读取方式。
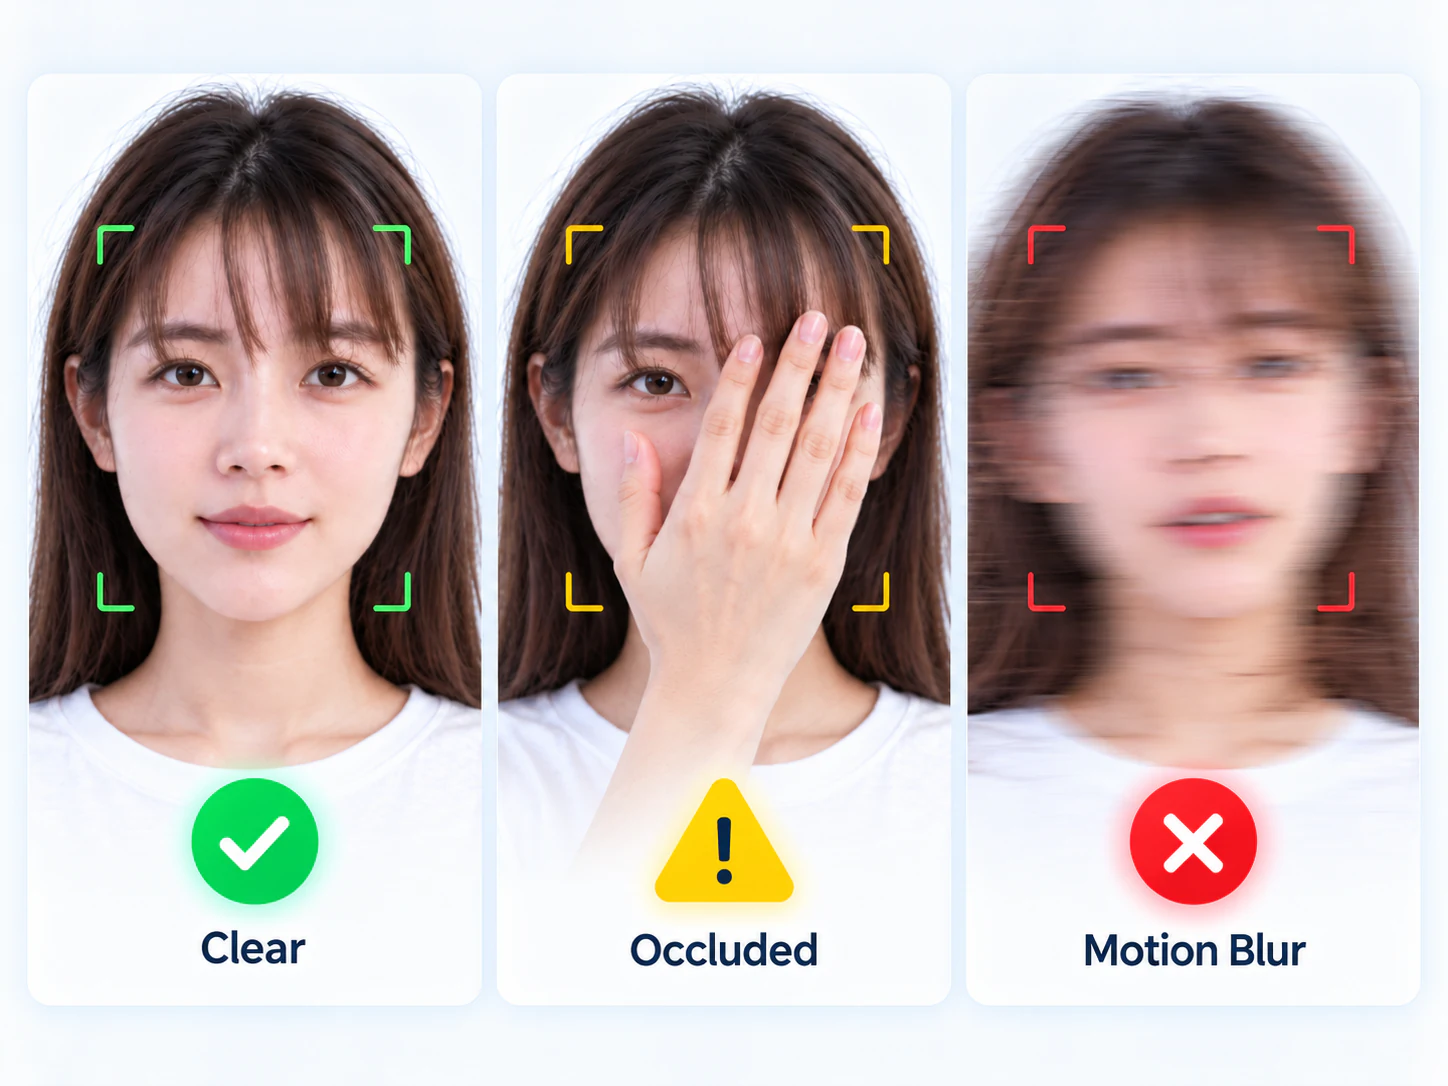
抓拍时,将质量分数与清晰度、亮度、姿态、人脸大小、引导框位置和人脸数量一起使用。抓拍模块会结合连续帧上的这些条件选择候选结果。
人脸关键点
关键点描述面部几何位置。SDK 可从检测结果中读取五个对齐点和一组稠密关键点,常用于人脸对齐、绘制叠加效果或测量跨帧运动。
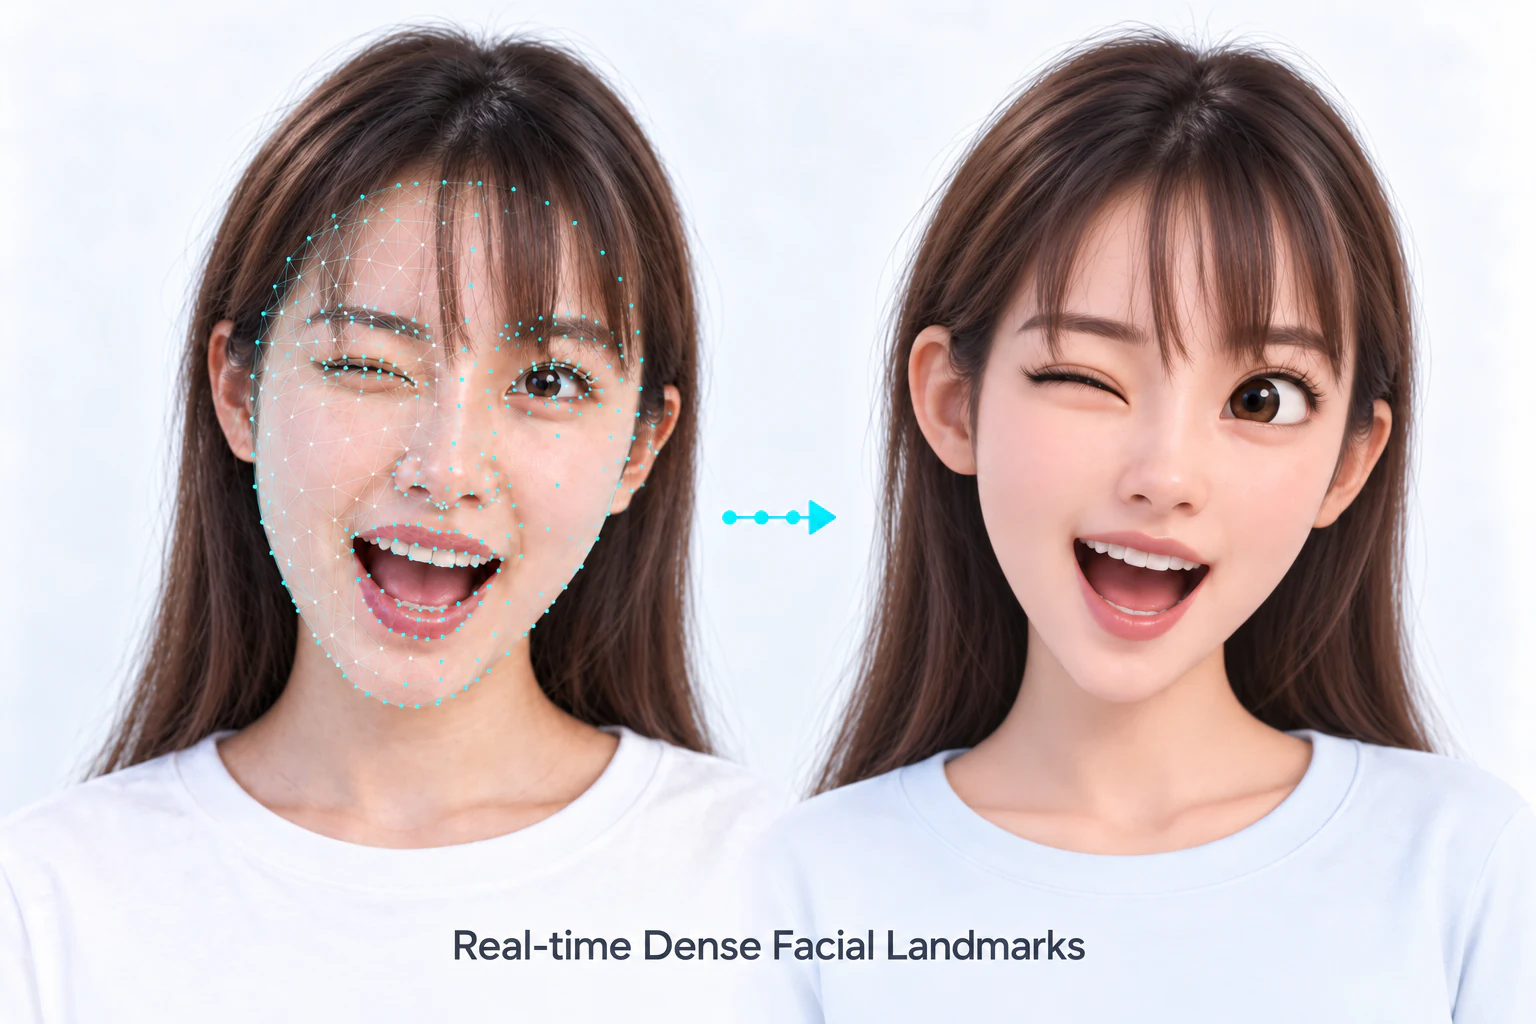
C 接口分配点数组前,应查询点数量。点位顺序由关键点引擎决定;下游逻辑依赖特定索引时,需要保持一致。视频平滑可以减少抖动,也会让快速动作的响应稍有延迟。详见关键点指南。
静默活体
RGB 活体模型根据人脸图像输出分数,不要求用户做动作。启用 HF_ENABLE_LIVENESS,对检测到的人脸执行分析流水线,再读取 RGB 活体分数。
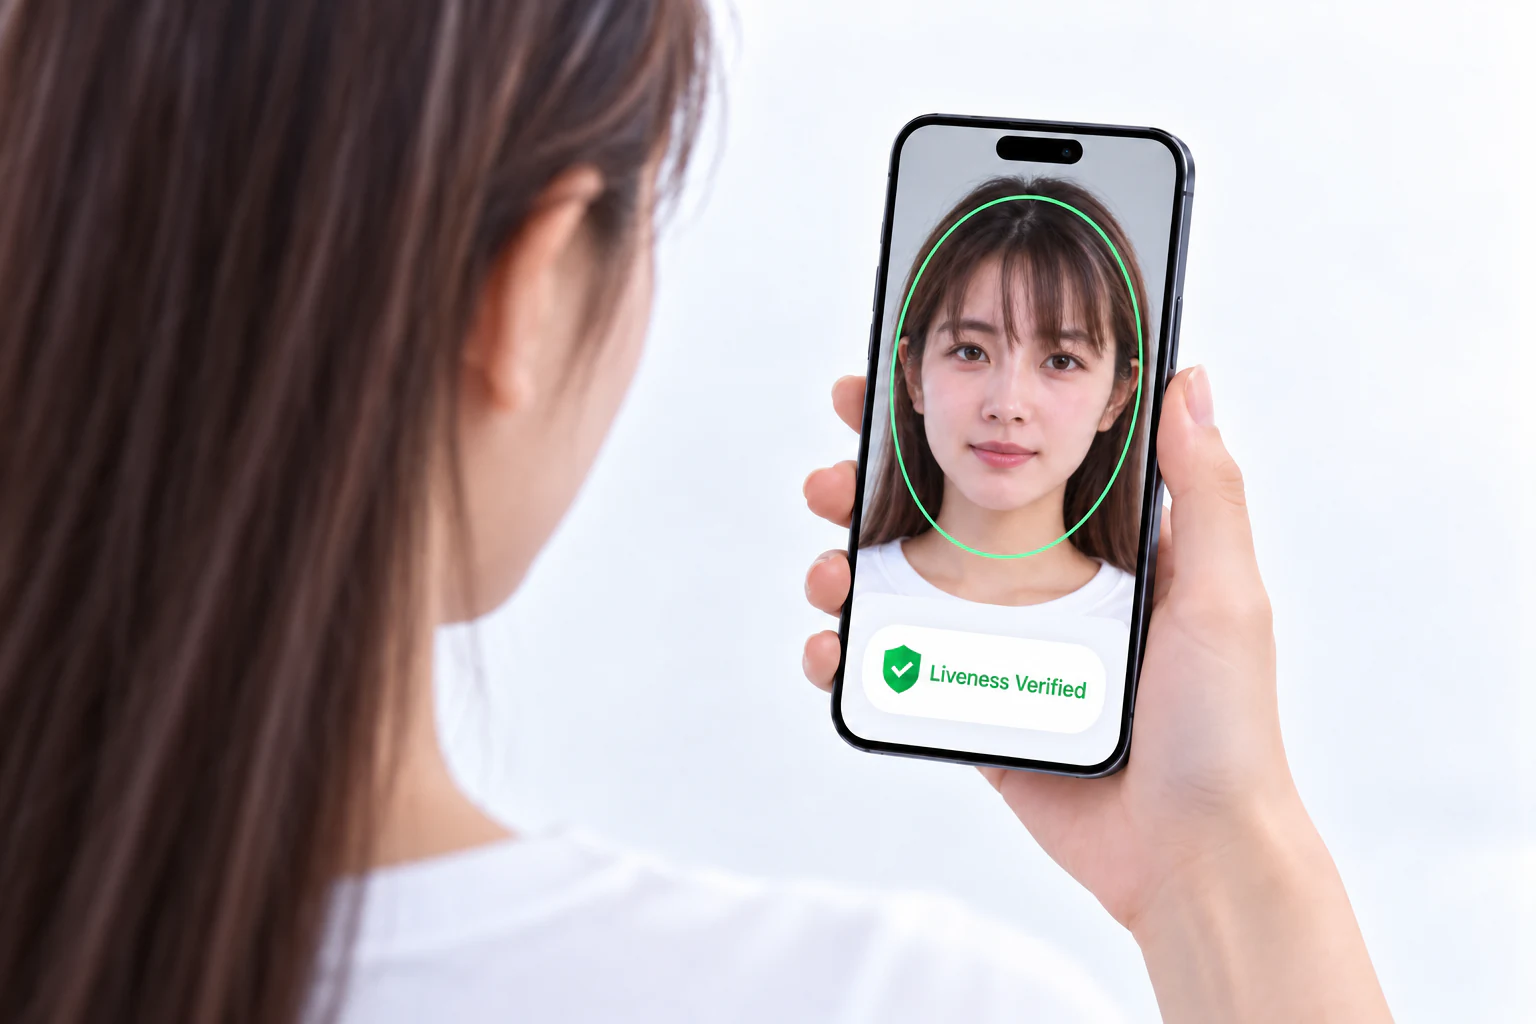
使用目标相机采集真实人脸、照片翻拍和屏幕回放,评估活体阈值。测试中覆盖实际使用时的光照、人脸尺寸和曝光条件。
活体指南说明了 SDK 调用流程,以及它与动作检测的区别。
头部姿态估计
启用 HF_ENABLE_FACE_POSE 后,可以随检测结果获取 roll、yaw 和 pitch,用于相机引导、正脸筛选和姿态显示。
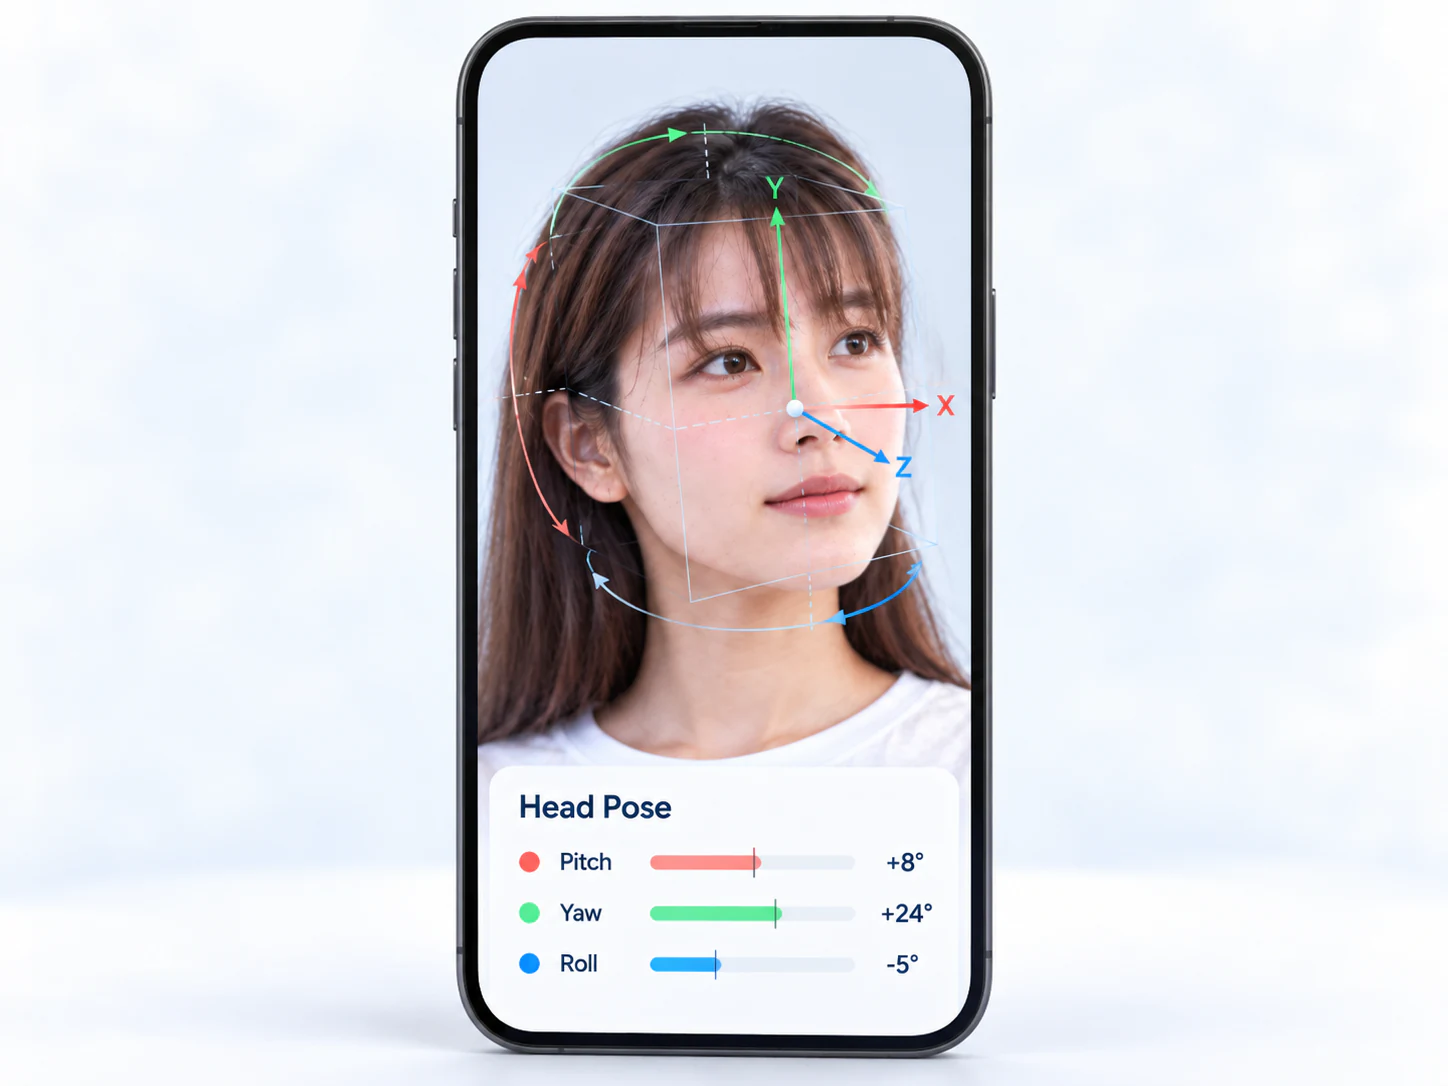
在镜像的前置相机预览上绘制时,需要对叠加结果应用一致的变换。旋转与镜像是两种操作,详见图像输入与坐标。
动作活体
交互模块返回眼睛状态分数,以及眨眼、张嘴、摇头、抬头等时序动作标记。带提示的交互流程可以使用这些结果推进动作挑战。
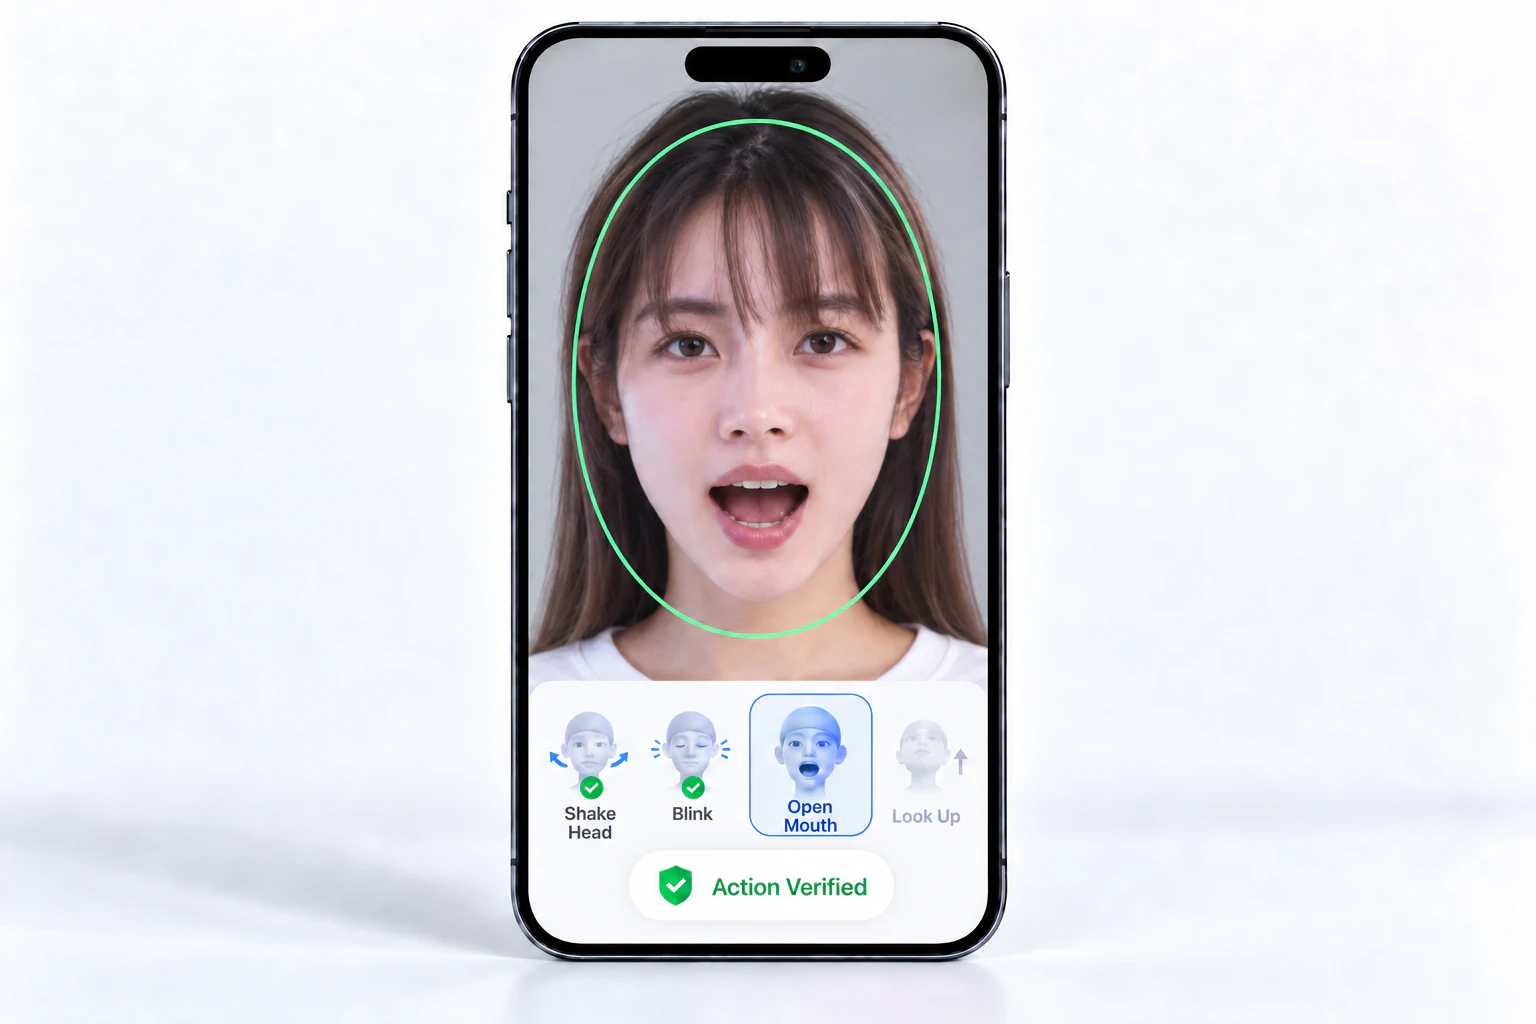
使用跟踪会话并提交连续帧,由应用管理提示顺序、超时和重试,分别记录动作完成情况与活体判断结果。完整交互流程见活体指南。
特征管理
FeatureHub 使用数值 ID 管理特征向量,支持插入、更新、删除、阈值检索、Top-k 检索和可选持久化。姓名及其他业务信息由应用存储,通过返回的 ID 关联。
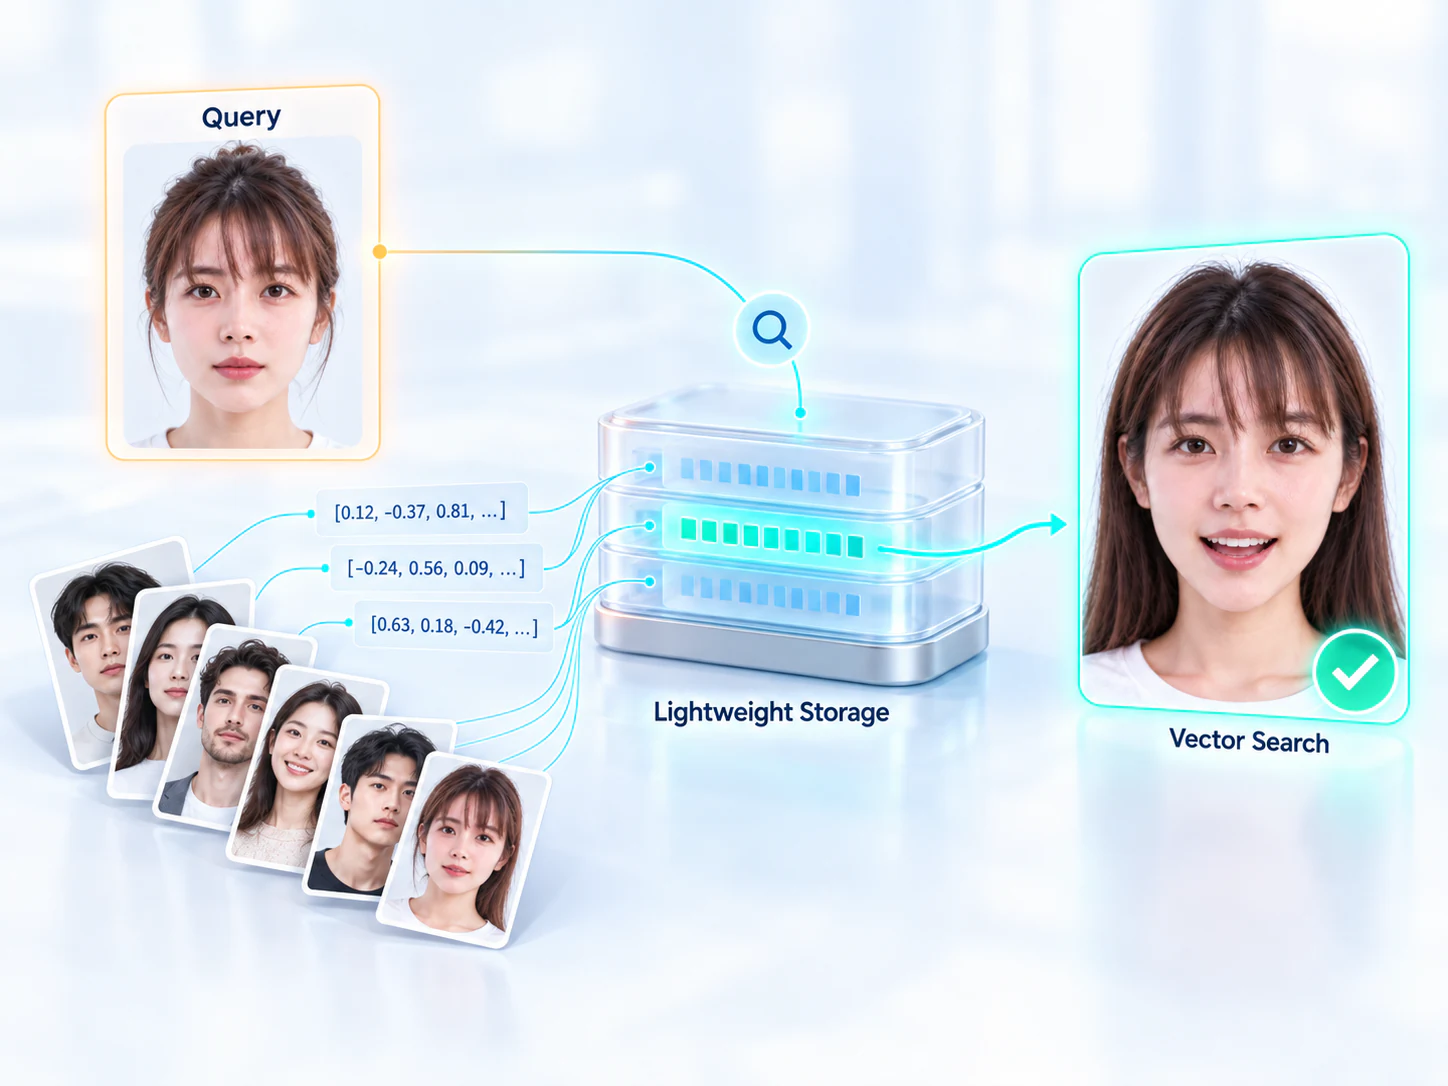
同一进程共享 FeatureHub。特征库初始化一次,等待使用它的任务结束后再关闭。需要最佳匹配时选择 exhaustive 检索;eager 检索可能在找到第一个过阈值结果时就停止。详见特征库示例。
硬件支持
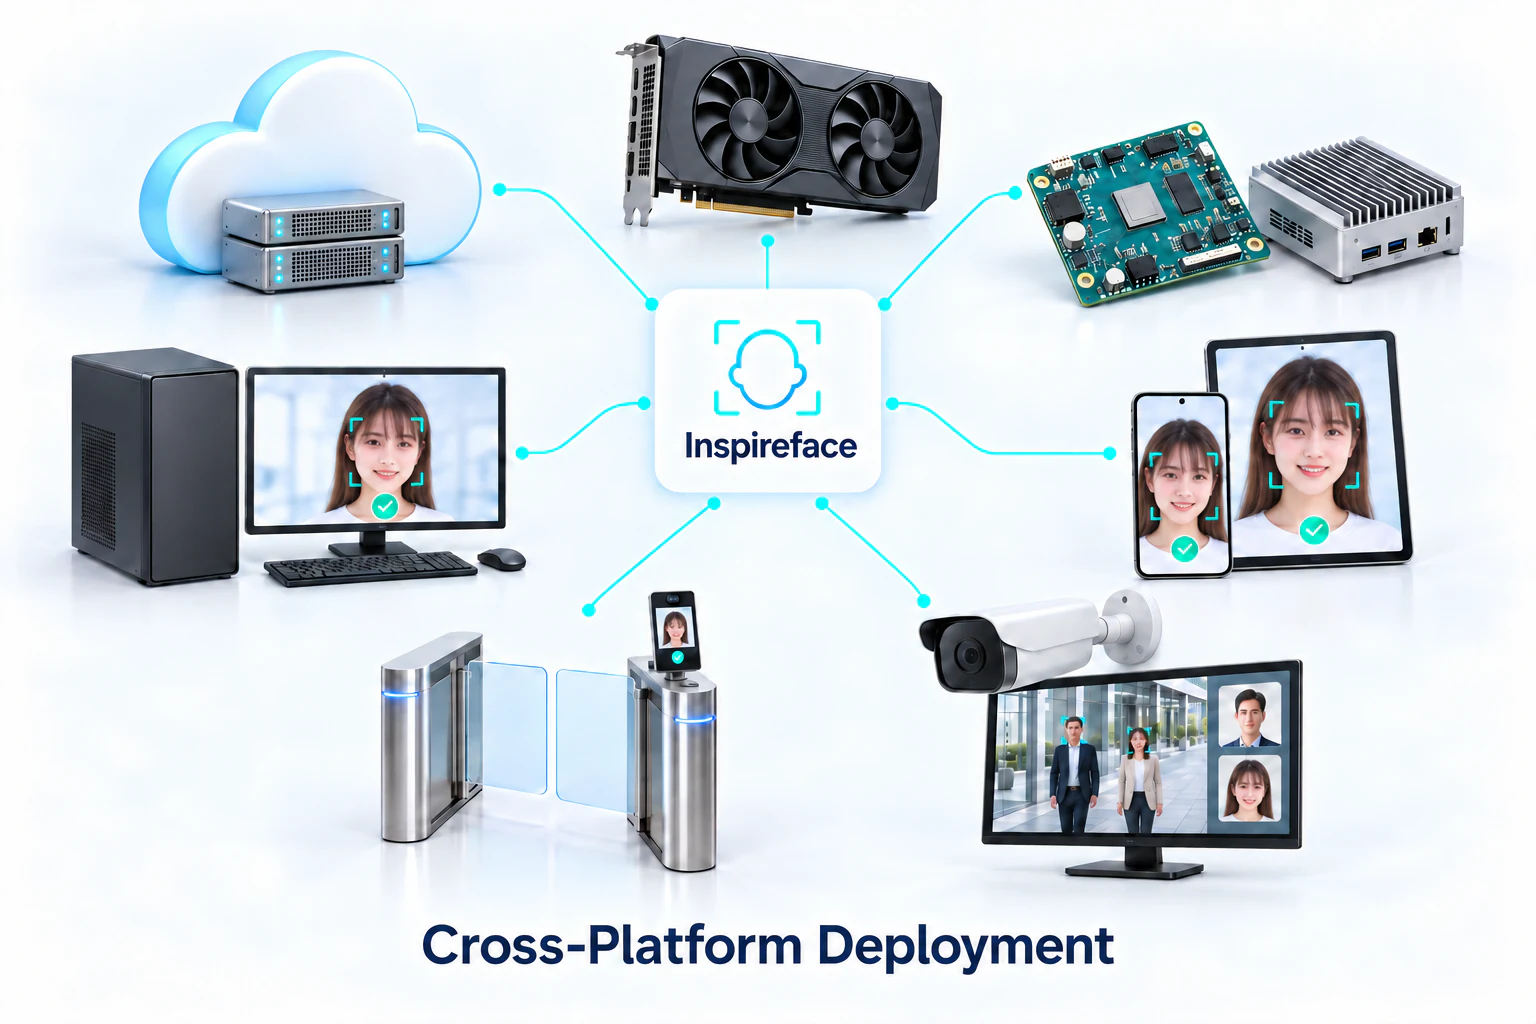
根据目标硬件选择计算后端,并搭配对应模型包。支持加速的模型使用所选后端,图像处理、跟踪逻辑和特征库检索等部分也会使用 CPU。
| Target | SDK 与模型包选择 | 接入说明 |
|---|---|---|
| CPU | 桌面、移动端和嵌入式设备可使用 CPU 构建,搭配 Pikachu 等通用模型包。 | 模型与构建 |
| iOS / macOS CPU | Objective-C、Swift Framework 与通用 CPU 模型包。 | Apple API · iOS · macOS |
| Apple CoreML | 启用 Apple 扩展,并搭配兼容的 Apple 模型包。 | iOS / Apple |
| Rockchip NPU | 使用 RKNN 构建,匹配 SoC 模型包和板端运行库。 | Rockchip |
| NVIDIA GPU | 使用 TensorRT 构建,搭配兼容的 TensorRT/CUDA 运行库和 TRT 模型包。 | CUDA / TensorRT |
可选活体演示
InspireFacePlus 提供被动 RGB 和屏幕炫光两种移动端核验流程。Android 示例由设备完成取景引导和采集,再将完整的一轮数据提交到服务端,取得活体结果。两个入口都位于 Anti-fraud 分类下,并带有 PLUS 标记。
PLUS 按对应的采集与服务协议接入;本地 RGB 评分使用 HF_ENABLE_LIVENESS。需要确认身份时,再接人脸识别或特征库匹配。
被动活体(PLUS)
被动活体在用户直视前置摄像头时采集一段 RGB 图像序列,不要求眨眼、转头,也不改变屏幕颜色。它适合人脸录入、账户核验中的自拍步骤:用户只需调整好手机位置并短暂保持稳定。
Android 示例先等待一张人脸在引导区域内保持稳定,再开放 Start verification 按钮。开始后采集 20 个连续有效帧,利用本地人脸检测和眼部关键点准备输入。短暂模糊或晃动打断连续性时,会重新收集连续片段;人脸丢失、出现多人或明显移动时,则停止本轮,提示重新采集。
序列完整后统一提交一次,服务端返回判断和分数;如果本轮数据不足以得出结论,则要求重新采集。这里返回整段采集的结果;本地 Silent liveness 页面则显示不断刷新的单帧分数,方便比较两种交互。完整流程见被动 RGB 采集。
炫光活体(PLUS)
炫光活体将前置摄像头采集与手机屏幕变化配合起来。用户保持不动,屏幕依次提供白、红、绿、蓝光照,服务端根据采集到的光照序列进行验证,过程中无需按提示做表情或头部动作。
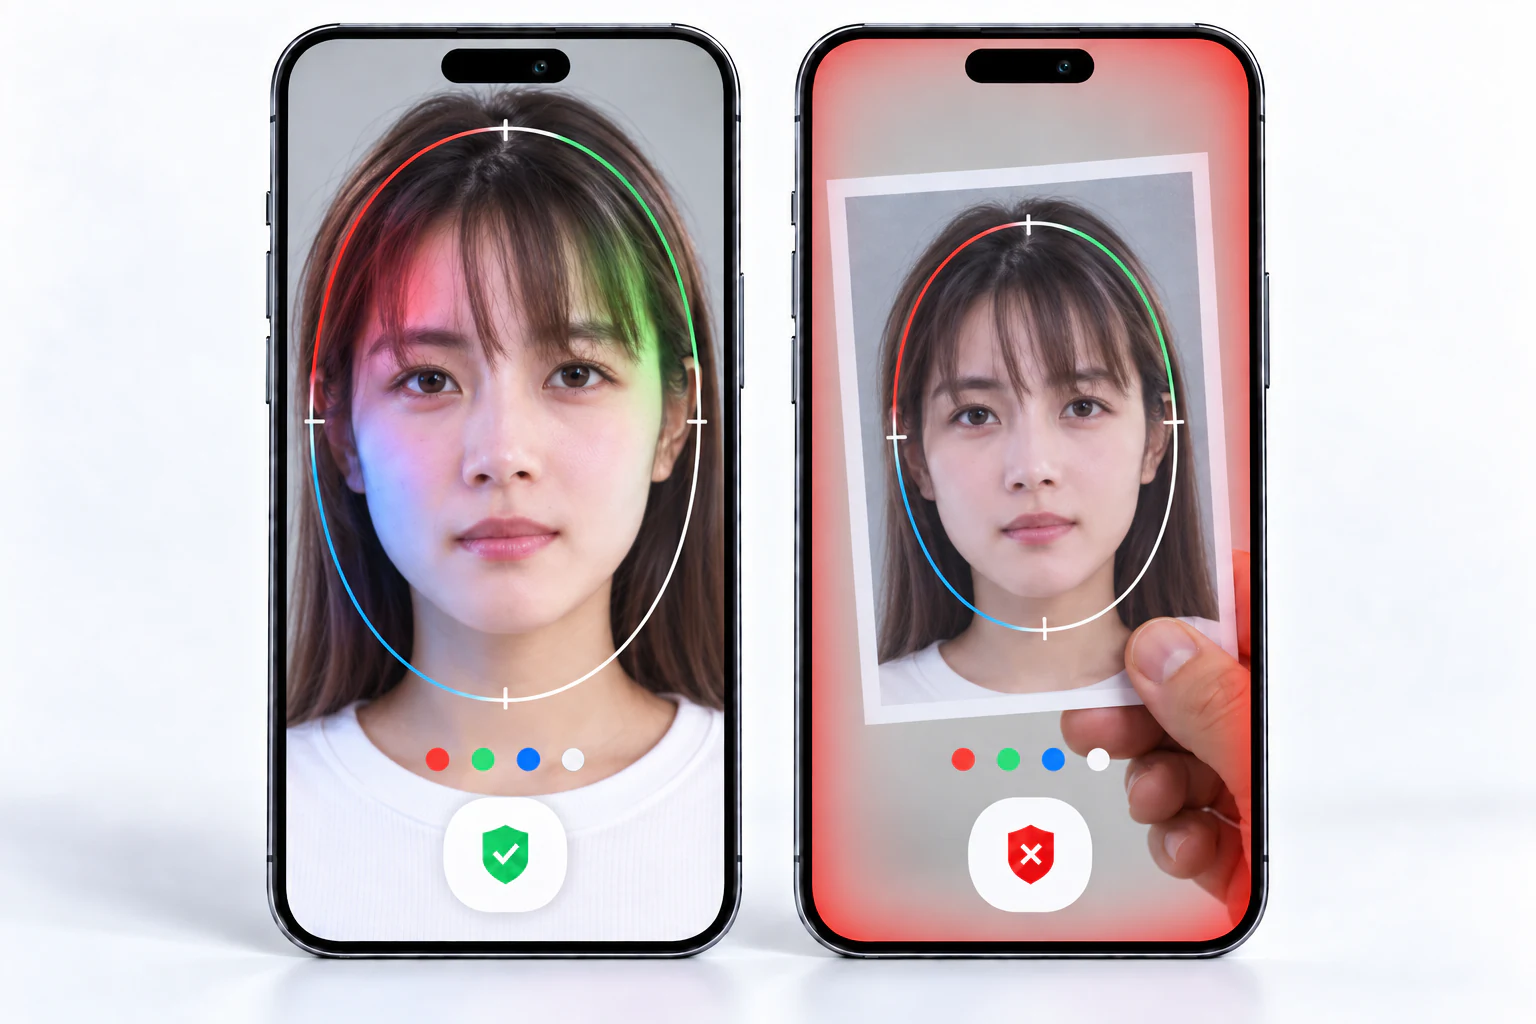
示例先在白光下等待曝光和白平衡稳定,再锁定这两个设置,依次等待各光照阶段稳定并采集。补光由手机屏幕提供。前置摄像头需要提供相应的曝光、白平衡和时间戳控制能力,确保采集图像与屏幕颜色对应;不支持的设备会在采集前显示能力提示。
它适合应用能够同时控制屏幕和摄像头、用户可以在光照变化期间保持稳定的核验步骤。相比被动采集,这种方式更依赖设备控制,接入时应使用实际目标机型验证。光照顺序、中断处理和结果状态见炫光采集流程。
这两个演示都需要网络连接。可以安装 Android 体验应用比较交互体验。如需商用版本使用权,可向 contact@insightface.ai 说明目标平台和使用场景。