使用 InspireCV 处理图像
InspireCV 是用于图像操作和模型输入预处理的 C++ 库,可以独立于 InspireFace 使用。默认构建采用 OKCV,OpenCV 为可选依赖。
文件读写、裁剪、缩放、绘制和简单滤波使用 Image;需要明确指定像素格式、变换、归一化或张量布局时,使用 task::Pipeline。以下示例使用 InspireCV 1.0.2。
CPU 与 OpenCV 的对比、CUDA 预处理和显存内连续操作的耗时,见图像处理性能测试。其中也有复测命令和原始 CSV。
NEON 图像算子和部署选项见 ARM 部署。
构建与链接
默认 CPU 构建需要 CMake 3.15 或更新版本,以及支持 C++14 的编译器:
git clone --recurse-submodules https://github.com/tunmx/InspireCV.git
cmake -S InspireCV -B build/inspirecv \
  -DCMAKE_BUILD_TYPE=Release \
  -DINSPIRECV_BUILD_EXAMPLES=ON \
  -DCMAKE_INSTALL_PREFIX="$PWD/local/inspirecv"
cmake --build build/inspirecv --parallel 4
cmake --install build/inspirecv
使用已安装的库时,链接导出的 CMake target:
cmake_minimum_required(VERSION 3.15)
project(image_app LANGUAGES CXX)
find_package(InspireCV CONFIG REQUIRED)
add_executable(image_app main.cpp)
target_compile_features(image_app PRIVATE cxx_std_14)
target_link_libraries(image_app PRIVATE InspireCV::inspirecv)
配置应用时传入 -DCMAKE_PREFIX_PATH=/path/to/local/inspirecv。如果直接集成源码,使用 add_subdirectory(InspireCV),并链接同一个 InspireCV::inspirecv target,该 target 会提供所需的头文件目录和依赖。
| Build option | Default | 说明 |
|---|---|---|
INSPIRECV_BUILD_EXAMPLES | OFF | 构建 example/ 下的示例。 |
INSPIRECV_BUILD_TESTS | OFF | 构建库的测试。 |
INSPIRECV_BACKEND_OPENCV | OFF | 使用基于 OpenCV 的 Image 实现。 |
INSPIRECV_TASK_ENABLE_ARM_NEON | ON | 启用受支持的 ARM NEON 预处理路径。 |
INSPIRECV_ENABLE_AVX2 | OFF | 为所有 x86 C++ 源文件启用 AVX2,要求目标 CPU 支持。 |
INSPIRECV_ENABLE_CUDA | OFF | 构建可选的 CUDA 预处理,要求 CMake 3.18 或更新版本。 |
切换后端时查看项目 CMake 选项。默认后端的 OpenCV 读写和 GUI 集成,与替换 Image 后端本身是不同配置。
读取、变换与保存图像
#include <inspirecv/inspirecv.h>
#include <iostream>

int main(int argc, char** argv) {
    if (argc != 2) return 1;
    auto image = inspirecv::Image::Create(argv[1], 3);
    if (image.Empty()) {
        std::cerr << "Cannot read image\n";
        return 2;
    }
    auto resized = image.Resize(640, 480);
    auto gray = resized.ToGray();
    auto blurred = gray.GaussianBlur(5, 1.2);
    if (!blurred.Write("processed.png")) return 3;
    return 0;
}
三通道文件输入使用 BGR 存储。Resize 返回新图像,默认使用双线性采样。这个示例直接拉伸到固定尺寸;需要保持宽高比时,按原比例缩放,再按需补边。
Image 支持移动,不支持复制。需要独立像素缓冲区时使用 Clone()。Image::Create(width, height, channels, data, false) 借用外部像素,调用方必须保证内存有效并避免并发写入;默认的 copy_data=true 会复制数据。
三通道文件像素使用 BGR,绘制和补边的颜色参数使用 RGB。
下面用同一张样例图展示各个操作的效果,每张图单独设置尺寸和参数。点击图片可查看原尺寸。

各组效果对照使用同一张原图。

去掉颜色,观察亮度和结构。

模糊后局部细节变得平滑。
裁剪、补边与绘制
Image 操作也适合生成预览图,或准备后续处理需要的局部图像。下面裁剪图像中央区域,补边后保存为独立输出,原图保持不变。
#include <inspirecv/inspirecv.h>

bool save_preview(const inspirecv::Image& image) {
    if (image.Empty() || image.Width() < 2 || image.Height() < 2) return false;
    auto roi = inspirecv::Rect2i::Create(
        image.Width() / 4, image.Height() / 4,
        image.Width() / 2, image.Height() / 2);
    auto crop = image.Crop(roi);
    auto preview = crop.Pad(16, 16, 16, 16, {32.0, 32.0, 32.0});
    auto border = inspirecv::Rect2i::Create(16, 16, crop.Width(), crop.Height());
    preview.DrawRect(border, {255.0, 128.0, 0.0}, 2);
    return preview.Write("preview.jpg");
}
使用实际检测框时,先把区域限制在输入图像范围内。补边会改变坐标:裁剪图的原点在补边后变成 (left padding, top padding),绘制关键点时要加上对应偏移。
| Operation | API | 说明 |
|---|---|---|
| Geometry | Resize, Crop, Pad, WarpAffine | 返回新图像;WarpAffine 需要明确的变换矩阵。 |
| Orientation | Rotate90, Rotate180, Rotate270, FlipHorizontal, FlipVertical | Image 旋转方向为顺时针。 |
| Color | SwapRB, ToGray | 转换后继续在应用中记录通道顺序。 |
| Filters | GaussianBlur, Threshold, Erode, Dilate | 腐蚀和膨胀要求单通道输入;Threshold 支持 binary thresholding。 |
| Comparison and blending | AbsDiff, MeanChannels, Blend | 图像尺寸应匹配;Blend 用 8-bit mask 表示第一张图的权重。 |
| Drawing | DrawLine, DrawRect, DrawCircle, Fill | 直接修改目标图像,颜色参数使用 RGB 顺序。 |
Image 示例目录提供了可以单独运行的几何变换、滤波、颜色处理和混合示例。
几何操作对照
缩放改变像素采样和输出尺寸;裁剪保留原图的一部分;补边扩大画布。这三种操作对坐标的影响不同。旋转或镜像后,绘制框和关键点时也要使用变换后的坐标。

由 325 × 325 缩小到 113 × 113。

将图像顺时针旋转 90°。

左右镜像,坐标也随之变化。

上下翻转。

仅保留原图中的 171 × 171 区域。

四边各补 50 像素,原图内容不缩放。
在副本上绘制
如果后面还要提取特征或执行其他分析,先用 Clone() 得到绘图副本,避免把线条和填充颜色作为模型输入。下面依次展示矩形、顶点、连线和区域填充;这些绘制方法直接修改目标图像。

在图像上绘制边界框。

在矩形顶点处画圆点。

使用不同颜色的线连接顶点。

用指定颜色填充选定区域。
通道和像素值
SwapRB() 改变通道顺序,Mul 和 Add 改变像素值,Reset 则替换整个缓冲区。8-bit 中间计算可能发生截断;需要保留小数或超出范围的值时,用下面的 float 图像。

交换红、蓝通道。

将像素值乘以 0.5,图像变暗。

8-bit 像素减去 175,超出下限的值截断。

用新的灰色缓冲区替换像素。
Float 图像与模型张量
Image 是 ImageT<uint8_t> 的别名。中间计算需要浮点像素时可以使用 ImageT<float>。以 float 读取文件会保留 [0, 255] 像素范围。需要归一化时,使用 Mul 或 Task 的 mean/scale 配置。
#include <inspirecv/inspirecv.h>

inspirecv::ImageT<float> load_unit_float(const std::string& path) {
    auto image = inspirecv::ImageT<float>::Create(path, 3);
    if (image.Empty()) return {};
    return image.Mul(1.0 / 255.0);
}
结果为 [0, 1] 范围的浮点值,采用通道交错的 HWC 存储,通道顺序为 BGR。需要 RGB、各通道不同的 mean/scale 或 CHW 存储时,使用下面的 Task Pipeline。ImageT<float>::Write 会将像素舍入并截断到 8-bit 图像文件;需要保留浮点值时,用应用所需的张量格式保存缓冲区。
Task 预处理
Task Pipeline 按配置完成坐标变换、采样、颜色转换和输出排列。坐标变换从目标位置映射回源图像,结果可以保存为独立的 Image,也可以写入调用方提供的张量缓冲区。
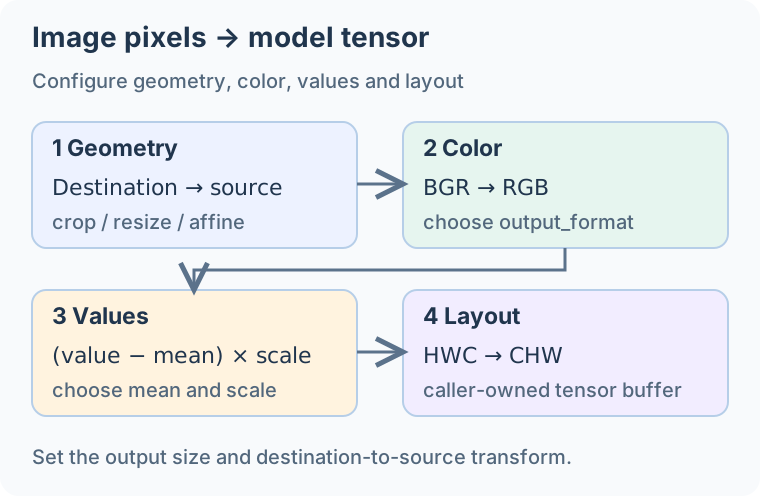
下面将缩放后的 BGR 图像转换为归一化的 RGB 浮点数据,并按 CHW 排列:
#include <inspirecv/task/pipeline.h>
#include <vector>

// image is a valid three-channel BGR Image.
auto resized = image.Resize(224, 224);
namespace task = inspirecv::task;
task::PipelineOptions options;
options.input_format = task::PixelFormat::kBgr;
options.output_format = task::PixelFormat::kRgb;
options.mean = {{127.5f, 127.5f, 127.5f, 0.0f}};
options.scale = {{1.0f / 127.5f, 1.0f / 127.5f, 1.0f / 127.5f, 1.0f}};
task::Pipeline pipeline(options);

std::vector<float> values(3 * 224 * 224);
task::TensorBuffer tensor;
tensor.data = values.data();
tensor.width = 224;
tensor.height = 224;
tensor.channels = 3;
tensor.element_type = task::ElementType::kFloat32;
tensor.order = task::TensorOrder::kChw;
auto status = pipeline.Run(resized, tensor);
// Only consume values if status == task::Status::kOk.
转换到配置的输出通道顺序后,浮点归一化按 (value - mean[channel]) * scale[channel] 计算。示例将 [0, 255] 映射到 [-1, 1]。接入模型时应使用模型实际要求的预处理参数。
TensorBuffer 描述的存储由调用方分配和持有。按尺寸、元素类型和步长,为 values 分配足够内存。步长为零时采用紧密排列的默认值。根据模型要求选择 HWC、CHW 或四通道打包布局。
将下面的代码分别保存为同一目录中的 preprocess.cpp 和 CMakeLists.txt,使用已安装的 InspireCV 构建。程序还会保存 resized.jpg,便于检查空间变换结果。
preprocess.cpp — 完整代码
#include <inspirecv/inspirecv.h>
#include <inspirecv/task/pipeline.h>
#include <algorithm>
#include <iostream>
#include <vector>

int main(int argc, char** argv) {
    if (argc != 2) {
        std::cerr << "Usage: preprocess IMAGE\n";
        return 1;
    }
    auto image = inspirecv::Image::Create(argv[1], 3);
    if (image.Empty()) {
        std::cerr << "Cannot read image\n";
        return 2;
    }
    // This example stretches to a square; use the transform your model expects.
    auto resized = image.Resize(224, 224);
    if (!resized.Write("resized.jpg")) {
        std::cerr << "Cannot write resized.jpg\n";
        return 3;
    }
    namespace task = inspirecv::task;
    task::PipelineOptions options;
    options.input_format = task::PixelFormat::kBgr;
    options.output_format = task::PixelFormat::kRgb;
    options.mean = {{127.5f, 127.5f, 127.5f, 0.0f}};
    options.scale = {{1.0f / 127.5f, 1.0f / 127.5f, 1.0f / 127.5f, 1.0f}};
    task::Pipeline pipeline(options);
    if (pipeline.ConfigurationStatus() != task::Status::kOk) return 4;

    std::vector<float> values(3 * 224 * 224);
    task::TensorBuffer tensor;
    tensor.data = values.data();
    tensor.width = 224;
    tensor.height = 224;
    tensor.channels = 3;
    tensor.element_type = task::ElementType::kFloat32;
    tensor.order = task::TensorOrder::kChw;
    const auto status = pipeline.Run(resized, tensor);
    if (status != task::Status::kOk) {
        std::cerr << task::StatusMessage(status) << '\n';
        return 5;
    }
    const auto range = std::minmax_element(values.begin(), values.end());
    std::cout << "RGB float tensor: 3 x 224 x 224, range ["
              << *range.first << ", " << *range.second << "]\n";
    return 0;
}
CMakeLists.txt — 完整代码
cmake_minimum_required(VERSION 3.15)
project(inspirecv_docs_example LANGUAGES CXX)
find_package(InspireCV CONFIG REQUIRED)
add_executable(preprocess preprocess.cpp)
target_compile_features(preprocess PRIVATE cxx_std_14)
target_link_libraries(preprocess PRIVATE InspireCV::inspirecv)
cmake -S . -B build -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_PREFIX_PATH=/path/to/local/inspirecv
cmake --build build --parallel 4
./build/preprocess face.jpg
检查 Pipeline 状态
创建 Pipeline 时检查 ConfigurationStatus(),之后检查 SetTransform 和每次 Run 的返回状态,分别处理配置、变换和输入错误。
#include <inspirecv/task/pipeline.h>
#include <iostream>

inspirecv::task::Status convert_checked(
        const inspirecv::Image& source, inspirecv::Image* output) {
    namespace task = inspirecv::task;
    task::PipelineOptions options;
    options.input_format = task::PixelFormat::kBgr;
    options.output_format = task::PixelFormat::kRgb;
    options.backend_preference = task::BackendPreference::kCpu;
    task::Pipeline pipeline(options);
    auto status = pipeline.ConfigurationStatus();
    if (status == task::Status::kOk) {
        status = pipeline.Run(source, source.Width(), source.Height(), output);
    }
    if (status != task::Status::kOk) {
        std::cerr << task::StatusMessage(status) << '\n';
    }
    return status;
}
这个示例明确选择 CPU,并保留输入尺寸。kDefault 继承进程级偏好;启用加速后,kAuto 和 kCuda 参与主机输入的 CUDA 调度。不受支持的 CUDA 请求仍可能在 CPU 上执行,因此记录性能数据时,应在成功调用后检查 LastExecutionBackend()。
上面的输出保存 RGB 像素。应用应随 Image 一起记录通道顺序;传给按 BGR 文件像素处理的操作前,用 SwapRB() 交换通道。
显式设置变换
同时设置输出尺寸和采样变换。Pipeline::SetTransform 接收从目标坐标回到源坐标的映射。所有尺寸都大于 1 时,align-corners 缩放可以这样配置:
auto transform = inspirecv::TransformMatrix::Create(
    float(source.Width() - 1) / float(output_width - 1), 0.0f, 0.0f,
    0.0f, float(source.Height() - 1) / float(output_height - 1), 0.0f
);
auto status = pipeline.SetTransform(transform);
// Check status before pipeline.Run(source, output_width, output_height, &output).
这个变换采用 align-corners 采样。做人脸对齐时,提供目标到源的对齐变换。检查 SetTransform 的返回状态;矩阵不可逆时,会保留之前的变换。
支持最近邻和线性两种采样方式。
下面的示例把旋转图像中的人脸区域映射到 112 × 112 输出,通过仿射变换选取并重采样该区域。
以旋转后的样例图为输入。

重采样得到 112 × 112 的对齐区域。
摄像头缓冲区与连续帧
RawImageView 通过宽、高和行步长描述借用的输入内存。例如,可以把紧密排列的 NV21 缓冲区直接转换成 BGR:
task::PipelineOptions options;
options.input_format = task::PixelFormat::kNv21;
options.output_format = task::PixelFormat::kBgr;
task::Pipeline pipeline(options);
task::RawImageView source;
source.data = nv21_bytes;
source.width = width;
source.height = height;
source.row_stride_bytes = 0;
inspirecv::Image bgr;
auto status = pipeline.Run(source, width, height, &bgr);
按声明的格式提供足够大的缓冲区,NV21 的宽高使用偶数。Android 分平面输入按实际步长重新排列,并将摄像头缓冲区保留到调用结束。JPEG 文件先解码,再创建原始图像视图。
| Method | 内存使用说明 |
|---|---|
Run(..., width, height, Image*) | 为输出图像分配独立内存,失败时保持目标不变。 |
RunInto(..., Image*) | 复用目标现有的缓冲区和尺寸,失败时可能已经修改部分内容。 |
Run(..., TensorBuffer) | 写入调用方提供的内存,需要事先分配足够空间。 |
相同配置的连续帧可以复用流水线。RunInto 避免替换输出图像缓冲区,但内部临时内存仍可能在首次需要时分配。源和目标使用独立缓冲区。流水线会复用可变执行状态,并发工作线程应各自使用独立实例。
可选的 CUDA 处理
构建时设置 INSPIRECV_ENABLE_CUDA=ON,然后在运行时启用加速:
bool enabled = inspirecv::task::SetCudaEnabled(true);
// false means this build or machine cannot enable CUDA.
对于主机输入的流水线,不受支持的 CUDA 请求可能回退到 CPU。测量性能时,在成功运行后检查 pipeline.LastExecutionBackend(),并在端到端对比中包含主机与设备之间的数据传输。
让连续操作留在 GPU 上
像素来自普通 CPU 内存时,主机输入接口使用方便。如果后续连续执行多个 GPU 操作,可以使用单独的 device API,减少每一步之间的下载和重新上传。
| API | 数据与执行约定 |
|---|---|
inspirecv::cuda::DeviceImage | 持有设备像素。Upload 和 Download 会同步;Resize、WarpAffine 和旋转操作提交到指定 stream。 |
task::cuda::Pipeline::Run | 将设备输入转换到调用方分配的设备张量内存。输入可以是 DeviceImageView,也可以是三通道 uint8 的 DeviceImage。 |
task::cuda::Pipeline::RunBatch | 接收输入、输出描述数组及数量;提交首个 kernel 前检查所有描述,整批任务进入同一个 stream。 |
inspirecv::cuda::Synchronize | 应用需要使用结果时,等待指定 stream 完成。 |
Device Pipeline 异步执行。为输入和输出张量分配设备内存,容量覆盖声明的尺寸和步长;stream 完成前保持这些缓冲区有效。RunBatch 将所有条目提交到传入的 stream,尺寸相同的条目可以复用几何缓存。
使用支持 CUDA 的构建,并显式启用加速。Device Pipeline 在 CUDA 上执行,通过返回状态检查设备是否可用、操作是否受支持。主机输入 Pipeline 的 CPU/CUDA 偏好单独配置。
完整接口见 DeviceImage 和 CUDA Task Pipeline。若希望自动加速部分 Image 操作,acceleration.h 提供 SetCudaAccelerationEnabled、SetAccelerationPreference 和 GetLastImageExecutionBackend。在目标设备上检查实际执行后端和传输耗时。
与 InspireFace 的关系
InspireFace 内部使用 InspireCV,并通过 InspireFace SDK 提供 inspirecv::FrameProcess。使用时包含 SDK 头文件,并选择 FrameProcess 自己的格式和旋转枚举。
构建 InspireFace 时设置 ISF_ENABLE_INSPIRECV_TASK_PREPROCESS=ON,即可在 SDK 内部使用 Task 预处理路径。
下面展示 FrameProcess 的输入帧、旋正后的处理预览和仿射区域输出。
带有旋转信息的侧向原始帧。

旋正后生成 160 × 160 的处理预览。

通过仿射变换读取目标对齐区域。